
1. PASCAL VOC란?
Computer Vision은 컴퓨터가 이미지나 영상에 포함된 정보를 인식하고 해석하도록 하는 기술이다. 예를 들어 사진 속에 고양이가 있는지, 자동차가 어디에 있는지 등을 판단하는 것이 이에 해당한다. 이러한 기능을 수행하는 AI 모델을 개발하려면 이미지뿐만 아니라 이미지에 무엇이 있는지를 알려주는 정답 데이터도 필요하다.
PASCAL VOC(PASCAL Visual Object Classes)는 Computer Vision 분야에서 이미지 속 객체를 인식하는 모델을 학습하고 성능을 평가하기 위해 만들어진 데이터셋 및 벤치마크로 이미지와 이에 대응하는 정답 정보인 Annotation을 제공하며, 서로 다른 모델을 동일한 기준으로 비교할 수 있도록 평가 방법도 정의한다. 컴퓨터 비전 및 머신러닝 분야에서 객체 인식과 검출 알고리즘의 성능을 평가하기 위한 PASCAL VOC Challenge는 2005년부터 2012년까지 진행되었으며, 그중 VOC2007과 VOC2012가 객체 탐지 연구와 학습에서 널리 사용된다.
즉, PASCAL VOC는 특정 AI 모델이나 알고리즘이 아니라 모델을 학습하고 평가하기 위한 데이터셋과 평가 체계이다.
2. PASCAL VOC 데이터셋의 구성
2.1 객체 클래스(Class)
PASCAL VOC2007부터는 총 20개의 객체 클래스를 사용한다.
- 사람(1개): person
- 동물(6개): bird, cat, cow, dog, horse, sheep
- 이동 수단(7개): aeroplane, bicycle, boat, bus, car, motorbike, train
- 실내 물체(6개): bottle, chair, dining table, potted plant, sofa, tv/monitor
따라서 전체 클래스 수는 다음과 같다.
\[
1+6+7+6=20
\]
하나의 이미지에는 서로 다른 클래스의 객체가 함께 존재할 수 있다. 예를 들어 자전거를 타고 있는 사람의 사진에는 person과 bicycle이 모두 포함될 수 있다. 또한 동일한 클래스의 객체가 여러 개 존재할 수도 있다. 고양이 세 마리가 포함된 사진이라면 cat 클래스에 해당하는 객체가 세 개 존재하는 것이다.
2.2 VOC2007과 VOC2012
PASCAL VOC는 발표 연도에 따라 여러 버전이 존재한다. 대표적으로 VOC2007과 VOC2012를 살펴보면 다음과 같다.
| 구분 | VOC2007 | VOC2012 |
| 객체 클래스 | 20개 | 20개 |
| 주요 작업 | Classification, Detection | Classification, Detection, Segmentation 등 |
| 학습·검증 이미지 | 5,011장 | 11,540장 |
| 테스트 이미지 | 4,952장 | 10,991장 |
| 테스트 정답 공개 | 공개 | 비공개 |
VOC2012의 경우 Classification 및 Detection 학습·검증 이미지에 약 27,450개의 객체가 Annotation되어 있다. 다만 Segmentation에 사용할 수 있는 정답 마스크는 전체 이미지에 제공되는 것이 아니라 일부 이미지에만 제공된다.
또한 VOC2012의 테스트 이미지에는 정답 Annotation이 공개되지 않으므로, 공개된 학습·검증 데이터만으로 테스트 정답을 직접 확인할 수는 없다.
2.3 Training, Validation, Test
PASCAL VOC는 모델의 학습과 평가를 위해 데이터를 구분한다.
- Training(train): 모델이 이미지와 정답을 이용하여 학습하는 데이터
- Validation(val): 학습 과정에서 모델의 성능을 확인하고 설정을 조정하는 데 사용하는 데이터
- Test(test): 최종 모델의 성능을 평가하는 데 사용하는 데이터
- Trainval: Training과 Validation을 합친 데이터
예를 들어 모델을 학습하는 과정에서는 Training 데이터를 이용하고, 모델의 설정을 선택할 때는 Validation 데이터를 참고할 수 있다. 이때 Test 데이터를 학습에 사용하면 모델의 일반화 성능을 공정하게 평가하기 어려워진다. 따라서 공식 벤치마크에서는 학습 데이터와 테스트 데이터를 구분하여 사용한다.
3. PASCAL VOC에서 수행하는 작업
PASCAL VOC는 다양한 Computer Vision 작업을 지원한다. 대표적인 작업은 Classification, Object Detection, Segmentation이다.
3.1 Image Classification
Image Classification은 이미지에 특정 클래스의 객체가 존재하는지를 판단하는 작업이다.
예를 들어 사람과 자전거가 함께 있는 이미지를 입력하면, 모델은 해당 이미지에 person과 bicycle이 존재한다고 예측할 수 있다.
여기서 중요한 점은 이미지에 객체가 존재하는지를 판단하는 것이며, 객체가 이미지의 어느 위치에 있는지는 반드시 알아낼 필요가 없다는 것이다.
또한 PASCAL VOC의 Classification은 한 이미지에 여러 클래스가 동시에 존재할 수 있는 Multi-Label Classification 문제이다.
3.2 Object Detection
Object Detection은 이미지 속 객체의 클래스와 위치를 함께 예측하는 작업이다.
예를 들어 자동차가 포함된 이미지를 입력하면 모델은 다음과 같은 정보를 예측한다.
- Class: car
- Bounding Box: 자동차가 위치한 사각형 영역
- Confidence Score: 해당 예측에 대한 모델의 신뢰도 점수
Bounding Box는 이미지 속 객체를 둘러싸는 사각형으로, 객체의 위치를 좌표로 나타낸다.
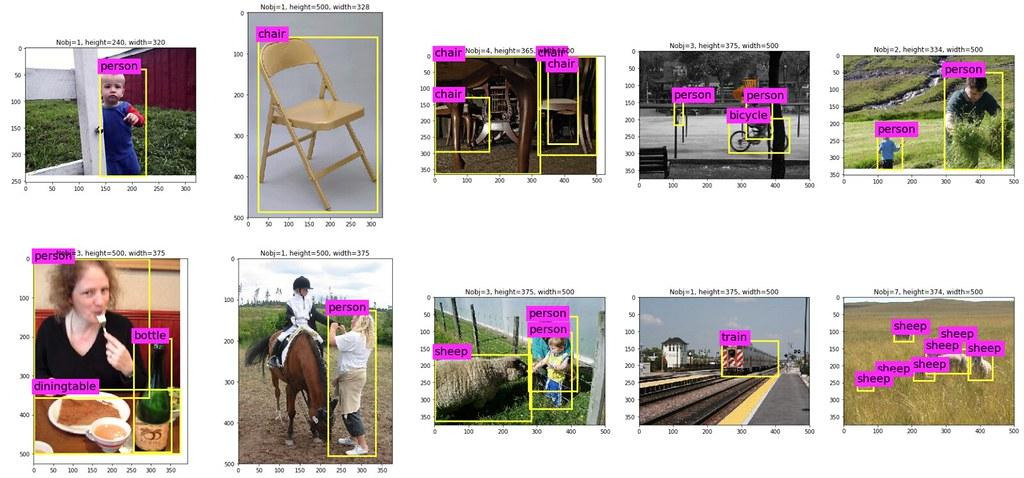
따라서 Image Classification이 이미지에 무엇이 있는지를 판단한다면, Object Detection은 무엇이 어디에 있는지를 함께 판단한다.
3.3 Semantic Segmentation
Semantic Segmentation은 이미지의 각 Pixel이 어떤 클래스에 속하는지를 분류하는 작업이다.
Object Detection이 객체를 사각형으로 둘러싼다면, Semantic Segmentation은 객체가 차지하는 영역을 Pixel 단위로 구분한다.
예를 들어 자동차와 사람이 함께 있는 이미지라면 자동차 영역에는 car, 사람 영역에는 person, 나머지 영역에는 background를 할당할 수 있다.
이처럼 각 Pixel에 할당한 정답 정보를 Segmentation Mask라고 한다.
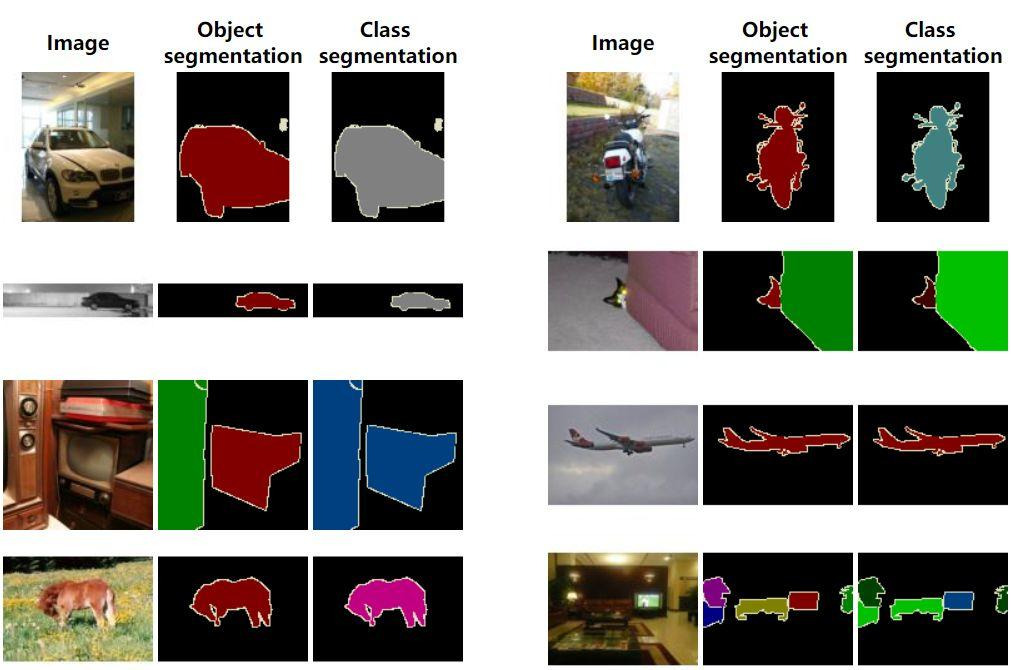
PASCAL VOC에서는 객체에 해당하지 않는 배경을 별도로 구분한다. 따라서 Semantic Segmentation에서는 20개의 객체 클래스와 background를 포함하여 총 21개 범주를 다룬다. 참고로 VOC의 Segmentation Mask에는 객체의 경계나 분류하기 어려운 영역을 나타내는 void 값(255)도 존재한다. 이 영역은 21개 평가 범주에 포함되지 않는다.
참고로 VOC2012에는 Class Segmentation과 Object Segmentation 형태의 정답 마스크가 제공된다. 다만 공식 Segmentation Challenge의 주요 목표는 Pixel 단위의 클래스 분류이며, 개별 객체를 각각 구분하는 Instance Segmentation과는 구별해야 한다.
이외에도 PASCAL VOC에는 사람의 행동을 분류하는 Action Classification과 사람의 신체 부위를 인식하는 Person Layout 등의 작업이 존재한다.
4. PASCAL VOC의 Annotation
4.1 Annotation이란?
Annotation은 이미지에 포함된 객체의 정답 정보를 표시한 데이터이다. 예를 들어 고양이가 포함된 이미지에서 Annotation은 다음과 같은 정보를 제공할 수 있다.
- 객체 클래스: cat
- 객체 위치: Bounding Box의 좌표
- 객체가 이미지 밖으로 잘려 있는지 여부
- 다른 객체에 의해 가려져 있는지 여부
- 객체를 식별하기 어려운지 여부
학습 과정에서 모델은 이미지에 대한 자신의 예측과 Annotation을 비교하여 오차를 줄이는 방향으로 학습한다.
4.2 XML 형식의 Annotation
PASCAL VOC의 객체 탐지 Annotation은 일반적으로 XML 형식으로 저장된다.
객체의 위치는 다음 네 좌표를 이용하여 표현한다.
- xmin: Bounding Box의 왼쪽 좌표
- ymin: Bounding Box의 위쪽 좌표
- xmax: Bounding Box의 오른쪽 좌표
- ymax: Bounding Box의 아래쪽 좌표
XML 파일의 주요 구조를 간소화하면 다음과 같다.
<annotation>
    <object>
        <name>cat</name>
        <bndbox>
            <xmin>...</xmin>
            <ymin>...</ymin>
            <xmax>...</xmax>
            <ymax>...</ymax>
        </bndbox>
    </object>
</annotation>
위 코드는 구조를 설명하기 위한 예시이며, 실제 Annotation 파일에는 이미지 크기, 객체의 상태 등 추가 정보가 포함될 수 있다.
이처럼 Bounding Box의 위치가 정답으로 주어지므로, Object Detection 모델은 이미지에서 객체의 위치와 클래스를 예측하도록 학습할 수 있다.
4.3 데이터 폴더 구조
VOC2012의 주요 데이터 폴더는 다음과 같이 구성된다.
VOC2012/
├── JPEGImages/
├── Annotations/
├── ImageSets/
│   ├── Main/
│   └── Segmentation/
├── SegmentationClass/
└── SegmentationObject/
각 폴더의 역할은 다음과 같다.
- JPEGImages: 원본 이미지
- Annotations: Bounding Box와 객체 클래스 등이 기록된 XML 파일
- ImageSets: Training, Validation 등의 데이터 목록
- SegmentationClass: 클래스별 Pixel Annotation
- SegmentationObject: 개별 객체별 Pixel Annotation
예를 들어 JPEGImages에 저장된 이미지와 Annotations에 저장된 동일 식별자의 XML 파일을 함께 사용하면 해당 이미지의 객체 탐지 정답 정보를 확인할 수 있다.
5. PASCAL VOC의 평가 지표
모델이 정답을 얼마나 정확하게 예측하는지 평가하기 위해서는 공통된 기준이 필요하다.
PASCAL VOC의 Object Detection에서는 주로 IoU, Precision, Recall, AP, mAP 등을 사용한다.
5.1 IoU(Intersection over Union)
IoU는 모델이 예측한 Bounding Box와 정답 Bounding Box가 얼마나 겹치는지를 나타내는 지표이다.
\[
\frac{|B_{\mathrm{pred}}\cap B_{\mathrm{gt}}|}
{|B_{\mathrm{pred}}\cup B_{\mathrm{gt}}|}
\qquad
\begin{array}{l}
B_{\mathrm{pred}}:\ \text{예측 영역}\\[6pt]
B_{\mathrm{gt}}:\ \text{정답 영역}
\end{array}
\]
분자는 두 사각형이 겹치는 영역의 넓이이고, 분모는 두 사각형이 차지하는 전체 영역의 넓이이다. 이때 겹치는 부분은 중복 계산하지 않는다.
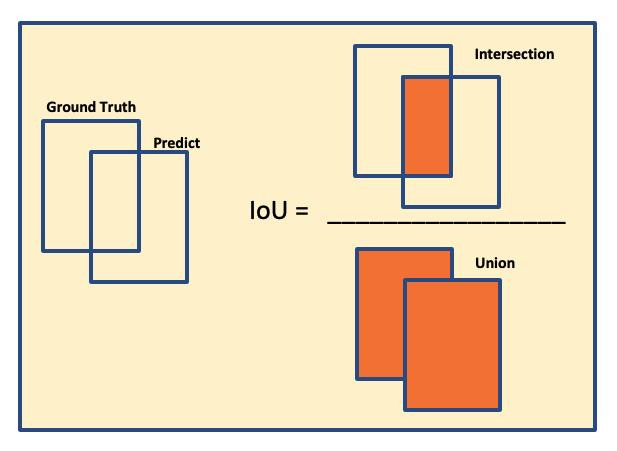
예를 들어 두 영역의 교집합 넓이가 \(60\,\mathrm{px}^2\), 합집합 넓이가 \(100\,\mathrm{px}^2\)라고 가정하자.
그러면 IoU는 다음과 같이 계산된다.
\[
\frac{60}{100}=0.6
\]
즉, IoU는 \(0.6\)이며 백분율로 표현하면 \(60\%\)이다.
IoU는 \(0\)에서 \(1\) 사이의 값을 가지며, 값이 클수록 예측 영역과 정답 영역이 잘 일치한다.
PASCAL VOC의 대표적인 Object Detection 평가에서는 IoU \(0.5\)를 기준으로 올바르게 탐지했는지를 판단한다. 단, 실제 판정에서는 객체 클래스의 일치 여부와 중복 탐지 여부 등도 고려한다.
5.2 Precision과 Recall
Bounding Box의 위치가 적절한지만으로 모델의 성능을 모두 평가할 수는 없다. 모델이 존재하지 않는 객체를 잘못 탐지하거나, 실제 객체를 놓칠 수도 있기 때문이다.
따라서 Precision과 Recall을 함께 고려한다.
Precision은 모델이 객체를 탐지했다고 판단한 결과 중 실제로 올바른 탐지의 비율이다.
\[
\mathrm{Precision}=\frac{TP}{TP+FP}
\]
Recall은 실제로 존재하는 객체 중 모델이 올바르게 찾아낸 비율이다.
\[
\mathrm{Recall}=\frac{TP}{TP+FN}
\]
여기서 각 변수는 다음을 의미한다.
- \(TP\)(True Positive): 올바르게 탐지한 객체
- \(FP\)(False Positive): 잘못 탐지한 결과
- \(FN\)(False Negative): 탐지하지 못한 실제 객체
예를 들어 Precision이 높다는 것은 모델의 탐지 결과 중 잘못된 탐지가 적다는 의미이다. 반면 Recall이 높다는 것은 실제로 존재하는 객체를 많이 찾아냈다는 의미이다.
5.3 AP와 mAP
Object Detection 모델은 일반적으로 각 탐지 결과에 Confidence Score를 함께 출력한다.
이 점수에 대한 기준을 조정하면 Precision과 Recall이 달라지며, 두 지표의 관계를 Precision-Recall Curve로 나타낼 수 있다.
AP(Average Precision)는 이 곡선을 이용하여 하나의 클래스에 대한 탐지 성능을 요약한 지표이다.
mAP(mean Average Precision)는 여러 클래스의 AP를 평균한 값이다.
PASCAL VOC의 20개 객체 클래스를 모두 평가한다면 다음과 같이 표현할 수 있다.
\[
\frac{1}{20}\sum_{c=1}^{20}\mathrm{AP}_c
\qquad
\begin{array}{l}
c:\ \text{클래스 번호}\\[6pt]
\mathrm{AP}_c:\ \text{클래스 }c\text{의 AP}
\end{array}
\]
즉, 각 클래스의 AP를 계산한 후 이를 평균하여 전체 객체 탐지 성능을 비교하는 것이다.
다만 VOC2007과 VOC2010 이후에는 AP를 계산하는 방식에 차이가 있다. VOC2007은 11개 Recall 지점에서 Precision을 측정하는 방식을 사용했고, VOC2010 이후에는 Precision을 보간하여 얻은 Precision-Recall Curve 아래의 면적을 이용한다.
따라서 서로 다른 모델의 mAP를 비교할 때는 동일한 데이터셋과 평가 방식을 사용했는지 확인해야 한다.
한편 Segmentation에서는 클래스별로 Pixel 영역의 IoU를 계산하고, 이를 평균한 mIoU(mean Intersection over Union)를 주요 성능 지표로 사용한다.
6. 정리
PASCAL VOC는 Computer Vision 모델의 학습과 성능 평가를 위해 만들어진 데이터셋 및 벤치마크이다.
이미지와 함께 객체의 클래스, 위치 등의 정답 정보를 제공하며, 모델의 성능을 공통된 기준으로 평가할 수 있도록 한다.
이번 글에서 살펴본 핵심 내용은 다음과 같다.
- Dataset: 이미지와 Annotation으로 구성되며, 총 20개의 객체 클래스를 제공한다.
- Image Classification: 이미지에 어떤 객체가 존재하는지 판단한다.
- Object Detection: 객체의 클래스와 위치를 Bounding Box로 예측한다.
- Semantic Segmentation: 이미지의 각 Pixel을 클래스별로 분류한다.
- Annotation: 모델 학습과 평가에 사용되는 객체의 정답 정보이다.
- IoU: 예측한 영역과 정답 영역이 얼마나 일치하는지 나타낸다.
- AP 및 mAP: 객체 탐지 모델의 성능을 평가하는 대표적인 지표이다.
PASCAL VOC를 이해하면 AI 모델이 이미지에서 객체를 인식하도록 학습하는 과정과 예측 결과를 평가하는 방법을 파악할 수 있다. 이러한 개념은 이후 YOLO, R-CNN, Faster R-CNN 등 Object Detection 모델의 동작 원리와 성능 평가 방법을 공부하는 데 기초가 된다.
참고자료
PASCAL VOC 공식 홈페이지
https://www.robots.ox.ac.uk/~vgg/projects/pascal/VOC/
PASCAL VOC2012 Challenge 공식 페이지
https://www.robots.ox.ac.uk/~vgg/projects/pascal/VOC/voc2012/
PASCAL VOC2012 Development Kit — Annotation 및 평가 방식
https://www.robots.ox.ac.uk/~vgg/projects/pascal/VOC/voc2012/htmldoc/index.html
PASCAL VOC2007 Development Kit
https://www.robots.ox.ac.uk/~vgg/projects/pascal/VOC/voc2007/htmldoc/
TensorFlow Datasets — PASCAL VOC 데이터셋 정보
https://www.tensorflow.org/datasets/catalog/voc